Jev 是 TypeSafe AI 在 2026 年 9 月推出的決策模型,它不生成文字,只回答你事先定義好的是非題、選擇題、評分題,每個答案附一個機率。一次呼叫約 0.4 秒、輸入每百萬 token 收 0.042 美元、輸出免費。
我每週寄的 AI 週報,選材一直是 gemini-2.5-pro 在做,篩出來的結果我不太滿意。這篇文章會用 9 月剛出的 Jev 做最基本的分類與評分,要不要放交給原本的 LLM,拿 41 則候選新聞實測這樣分工在繁體中文上準不準、判斷依據該怎麼寫、怎麼串進 n8n 跟 Claude Code,還有註冊時遇到的問題。
Jev 是什麼?跟 LLM 差在哪
ChatGPT、Claude 這類 LLM(大型語言模型)是把答案一個字一個字寫出來給你看。Jev 不寫字,你先列好幾個選項,回來的是每個選項的機率。
三種題型:是非、選項、評分
- 是非題(noul):回 0 到 1,例如「這是不是新聞」→ 0.93
- 選擇題(choice):從你列的選項挑一個,例如「放哪個分類」→ 模型與工具 0.99
- 評分題(score):照你寫的判斷依據打分,例如「相關度 0~3」→ 1.98
三種題可以塞在同一次呼叫,一次算完,0.4 秒左右。
跟 LLM 的分工
| 比較項目 | Jev | LLM |
|---|---|---|
| 回什麼 | 機率、選項、分數 | 一段文字 |
| 速度 | 0.4 秒 | 1 秒到幾十秒 |
| 價格 | 一則新聞 $0.00004 | gemini-2.5-flash 7 倍、gemini-2.5-pro 400 倍 |
| 會不會解釋 | 不會 | 會 |
| 會不會寫字 | 不會 | 會 |
LLM 負責寫,Jev 負責選。TypeSafe 自己說它跟 GPT 那級的模型判斷一致率差不多、快 190 倍、便宜 440 倍,這些是官方的數字,還沒有第三方重現過。
Jev 能拿來做什麼
它適合的事有一個共同點:答案是有限的幾個選項,而且不需要解釋。
- 過濾雜訊:這封信是不是垃圾、這則貼文要不要回、這篇候選是不是廣告。
- 分流與分類:客服工單該給哪組、新聞該進哪個分類、使用者想做的是哪件事。
- 評分排序:搜尋結果重排、候選文章的相關度、客訴的嚴重程度。
- 驗證 LLM 的輸出:LLM 引的那句話原文有沒有、回答有沒有偏題、有沒有被提示詞注入。
相反的,要它算數、比日期、讀圖片、寫一段話,官方文件直接列在「已知缺陷」裡叫你別做。
📖 延伸閱讀:AI 怎麼查資料、寄信、操作資料庫?拆解 Tool Calling 運作原理
我的週報選材哪裡不滿意
我每週日寄的 AI 週報,新聞是 SerpApi 抓的,選材是 gemini-2.5-pro 吃一段固定提示詞,決定這則要不要、放哪類。一開始用 gemini-2.5-flash,輸出常常不照提示詞的規則,換成 pro 之後才穩定,但兩件事一直沒解決:股價新聞、活動宣傳常常混進候選,我每週審稿都在手動刪;pro 一則要跑十幾秒,偶爾還會 504 超時。
選材的前半段是選擇題:這是不是新聞、放哪類、跟讀者有多相關。9 月 Jev 出來,TypeSafe 說它就是做這種題的,我就拿同一批候選來試。
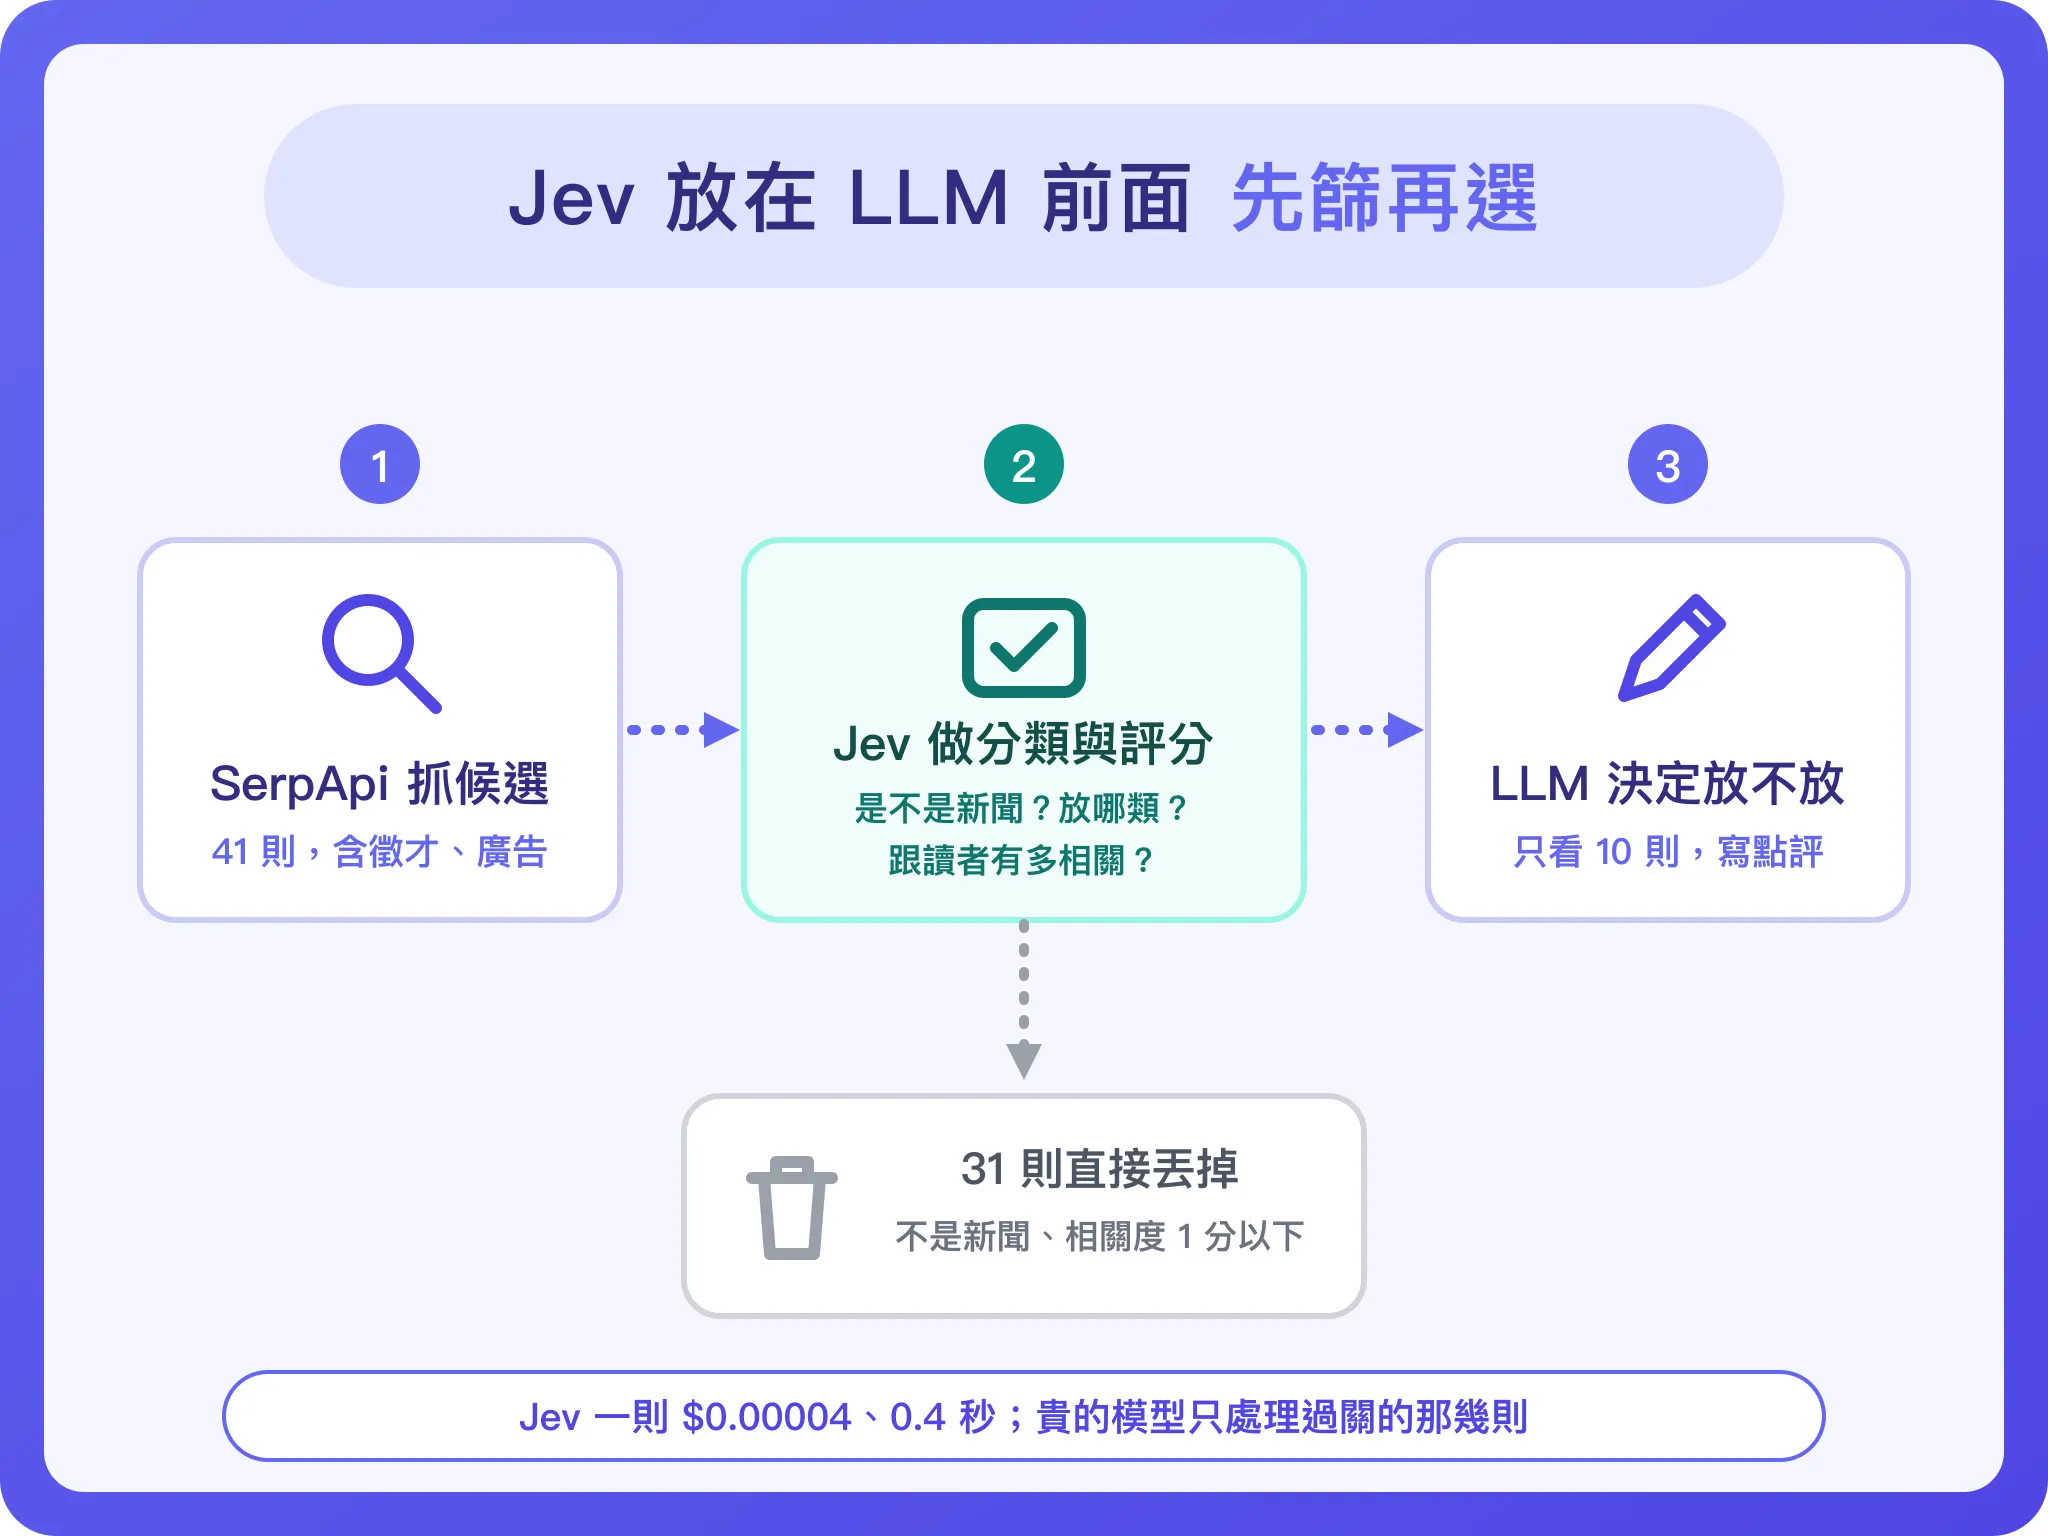
我怎麼分工:Jev 做基本分類與評分,LLM 決定放不放
Jev 只做最基本的分類與評分
我沒有把整個選材交給 Jev,只給它三個最基本的判斷:
| Jev 判什麼 | 題型 | 回什麼 | 程式拿來做什麼 |
|---|---|---|---|
| 這是不是報導具體事件的新聞 | 是非題 | 0~1 的機率 | 0.5 以下直接丟掉(徵才、廣告、社群貼文) |
| 放哪個分類 | 選擇題 | 五個分類各自的機率 | 先貼上分類標籤 |
| 跟讀者有多相關 | 評分題 | 0~3 分 | 1 分以下丟掉 |
留下來的候選才進 gemini-pro,由它決定最後放不放、寫摘要跟點評。Jev 負責篩,LLM 負責選跟寫,貴的模型只看過關的那幾則。
送給 Jev 的請求格式
新聞放 state,三個問題放 questions,判斷依據寫在 criteria,一次 POST 送出:
{
  "model": "typesafe/jev-1.13",
  "state": { "title": "Google 發布最新語音 AI 模型", "snippet": "...", "source": "..." },
  "questions": {
    "is_news": { "type": "noul", "instructions": "這是一則報導具體事件的新聞",
      "criteria": { "true": "報導某公司、產品、政策發生的具體事件",
                    "false": "工具比較文、教學、徵才、課程廣告、社群貼文、榜單" } },
    "category": { "type": "choice", "instructions": "這則新聞最適合放在週報的哪個分類",
      "criteria": { "headline": "本週頭條", "models_tools": "模型與工具", "automation_agent": "自動化與 Agent",
                    "chinese_community": "華語圈動態", "industry": "產業觀察" } },
    "relevance": { "type": "score", "instructions": "這則新聞對「用 n8n 做自動化、關心 AI 工具的台灣中小企業與行銷人」有多值得放進週報",
      "criteria": ["跟 AI 工具或自動化無關", "有關,但只是股價、融資、評論、活動宣傳",
                   "報導某個 AI 模型、功能、價格的發布、更新、洩漏或測試結果", "讀者下週工作會直接受影響"] }
  }
}
回來的是 "is_news": 0.93、"category": "models_tools"、"relevance": 1.98 這樣的數字,n8n 裡接一個 IF 節點就能用。
實測結果只看三個數字
我拿同一批 41 則候選(繁中 29、英文 12,故意留著徵才、課程廣告、Threads 貼文這些雜訊),Jev 跟 gemini-pro 各判一次,對照結果:
| 看什麼 | 結果 | 意思 |
|---|---|---|
| 「這是不是新聞」跟 gemini-pro 一致 | 97% | 擋雜訊這件事中文也準 |
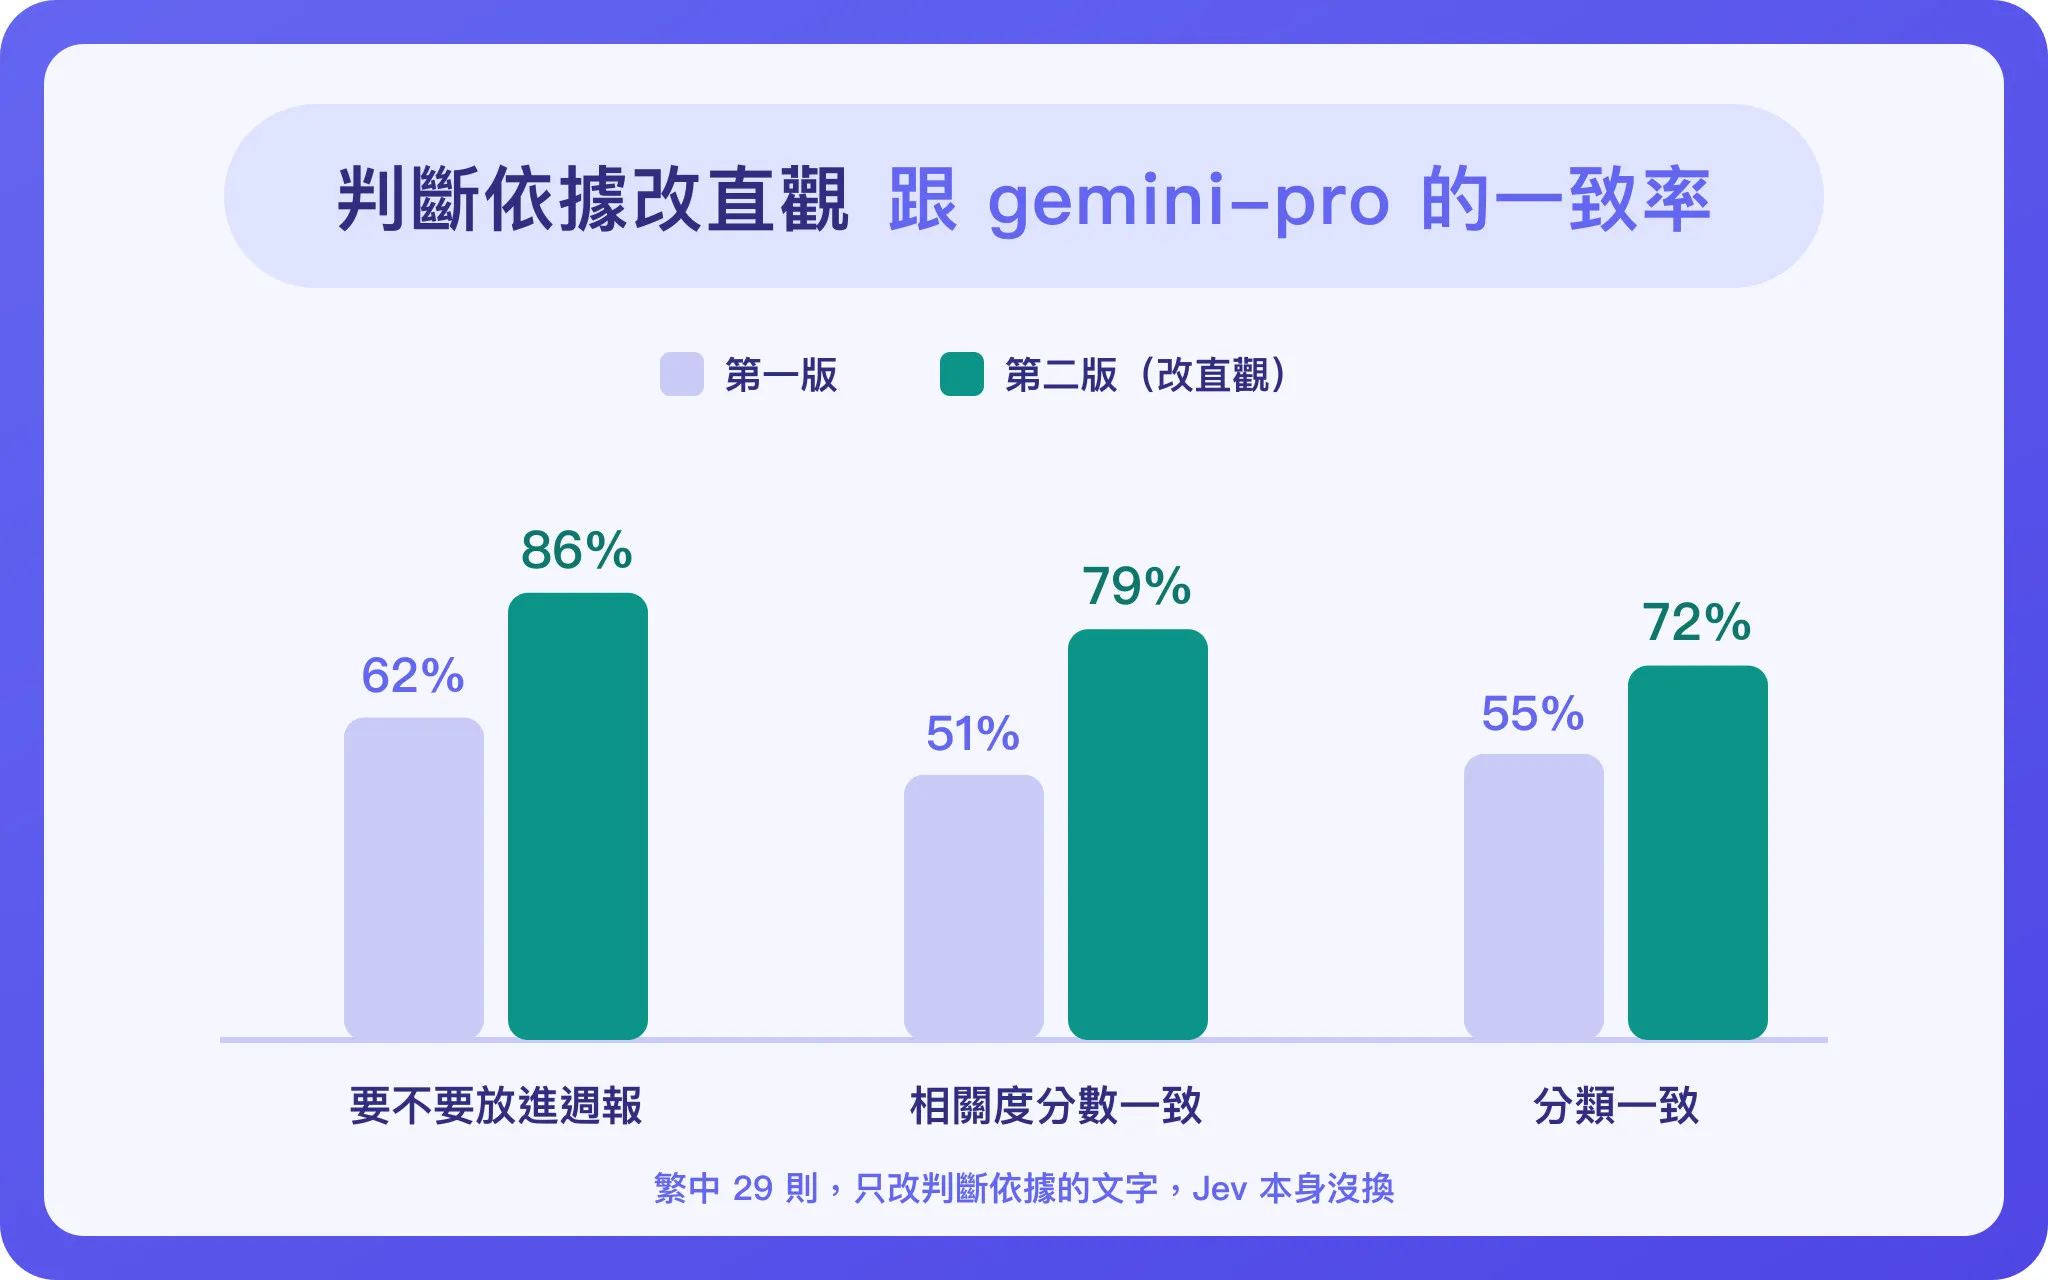
| 「要不要放進週報」跟 gemini-pro 一致 | 86% | 判斷依據改直觀後的數字,改之前 62% |
| 每則成本/速度 | $0.00004/0.4 秒 | gemini-pro 是 $0.0166/16 秒 |
41 則裡有 31 則在 Jev 這關就被擋掉,gemini-pro 只處理剩下的 10 則。跟它自己挑的 13 則比,9 則重疊;沒重疊的多半是同一件事的不同報導。
判斷依據要寫得很直觀
第一版的判斷依據哪裡出問題
第一次跑,41 則裡 31 則被 Jev 給了 1 分,只有 2 則過關。我回頭看判斷依據,第 2 級寫的是「新工具、新價格、新功能現在就能用」。Anthropic「考慮」發布新模型、Gemini「疑似」偷跑,照字面都不是「現在就能用」,Jev 全部給 1 分。
gemini-pro 用同一份判斷依據時會多一層「編輯應該會想要這種新聞」的推論,Jev 沒有這層推論。官方文件的已知缺陷第一條就是這個:照字面判斷,不推測你的用意。
改成直觀的寫法
| 級距 | 第一版 | 第二版 |
|---|---|---|
| 1 分 | 有關但只是小更新或八卦 | 有關,但只是股價、融資、人事、評論、活動宣傳 |
| 2 分 | 有實際影響:新功能現在就能用 | 報導某個 AI 模型、功能、價格的發布、更新、洩漏或測試結果 |
改完重跑,「要不要放」的一致率從 62% 到 86%,過關的從 2 則變 10 則。同一份判斷依據,每次跑出來的結果都一樣。相對的,每一級都要寫成具體的例子,像「新模型發布」「價格調整」這種,不能只寫「有實際影響」,中文尤其如此。
📖 延伸閱讀:AI 幻覺跟 AI 說謊差在哪?Bengio 解釋 AI 為什麼會作弊
Jev 哪三件事還不能交給它
三件事我不會交給它:
- 分類:中文一致率 72%,英文 91%,官方也寫明英文是主要訓練語言,所以分類標籤我只當參考,最後還是 LLM 定。
- 中等信心的答案:confidence(信心值)0.95 以上的答案跟 gemini-pro 一致 94%,0.5 到 0.95 之間的只有五成左右。所以我只讓 0.95 以上的自動通過,其他的還是交給 LLM 或人工再判一次。
- 寫回覆:它只回數字,不生成文字。客訴信要不要退款、該轉哪個部門,這種選擇題可以交給它;但回給客人的那封信、週報裡的點評,還是要 LLM 來寫。分歧的那幾則我也得自己回去讀原文猜是哪個字影響了結果,它給不了理由。
怎麼串進 n8n 跟 Claude Code
n8n 裡只多兩個節點
Jev 沒有 n8n 原生節點,但它就是一次 HTTP 請求,用 HTTP Request 節點就能打。整條流程變成:SerpApi 抓到候選 → HTTP 節點送給 Jev 做分類與評分 → IF 節點把不是新聞、相關度太低的丟掉 → 剩下的才進 gemini-pro 寫摘要跟點評。原本的流程一個節點都不用改,只是在 LLM 前面多插兩個。
📖 延伸閱讀:n8n 是什麼?2026 n8n 完整教學:從部署、節點解析到 AI Agent 應用
Claude Code 裝官方 skill
TypeSafe 有出 Claude Code 的 plugin,兩行裝好:
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai
裝完在對話框打 /typesafe:typesafe-ai,會先讀官方文件再寫串接的程式。這次實測的三支腳本(抓候選、跑三個裁判、算一致率)就是這樣請 Claude Code 寫的,我做的是改判斷依據跟看結果。Jev 只能當你程式裡的一個判斷函式,換不掉 Claude Code 背後那顆模型,官方文件特別寫了一頁講這個。
📖 延伸閱讀:Claude Code 教學:安裝、費用到資料安全一次搞懂
怎麼註冊 Jev
官網註冊送 5 美元
正規路線是到 console.typesafe.ai 註冊,9 月 21 日 TypeSafe 在 X 上宣布取消 waitlist,新帳號送 5 美元額度,約 1.2 億個輸入 token。API key 在 console 的 keys 頁建,端點是 https://api.typesafe.ai/v1/systemone。
顯示 we're full 怎麼辦
我 22 日下午去註冊,畫面只有一行「Whoops, we're full」。他們的 models 頁也寫著速率限制會隨 GPU 到貨動態調整,這陣子進不去不算意外。過幾天再試是一條路,但我不想等。
改走 OpenRouter
OpenRouter 也接了 Jev,端點是 /api/v1/systemone,模型名 typesafe/jev-1.13,請求跟回應格式跟官方一模一樣,價格也是 0.042 美元。本來就有 OpenRouter 帳號的人不用另外註冊,這篇的 41 則就是這樣打的。多繞一跳延遲從官方說的 0.1 秒變成我量到的 0.37 秒,選新聞這種用途感覺不到差別。
常見問題 FAQ
Q1:Jev 中文準不準?
是非題準,評分跟分類要看判斷依據怎麼寫。我 41 則繁中英文混合的新聞實測,「這是不是新聞」繁中跟 gemini-2.5-pro 一致 97%;「要不要放」第一版判斷依據只有 62%,改成不需要推論的寫法後到 86%;分類 72%,比英文的 91% 低。官方也明講英文是主要訓練語言。中文可以用,但判斷依據要寫得比給 LLM 的更直觀,而且要拿自己的資料先跑一遍。
Q2:Jev 可以取代 LLM 做選材嗎?
過濾那一段可以,最後決定跟寫摘要不行。同一批 41 則候選,Jev 擋掉 31 則,剩下 10 則跟 gemini-pro 自己挑的 13 則有 9 則重疊,而且每則便宜 400 倍、快 40 倍。但它不能寫摘要、不能解釋為什麼選,所以我的做法是 Jev 先篩,LLM 再決定。
Q3:Jev 一次呼叫可以問幾題?
沒有題數上限,限制是 token:一次請求 state 加所有題目合計 64k token,state 加最長的一題不能超過 32k。所有題目平行評估,state 只算一次錢,官方 cookbook 測過 13 題打包比分開打便宜 12 倍。我這次每則新聞三個問題約 1,000 token,因為題目跟判斷依據都是中文,中文吃的 token 比英文多。
Q4:Jev 的 confidence 跟機率有什麼不同?
機率是每個選項各自的數字,加起來是 1;confidence 是從整個機率分布的集中程度算出來的一個總分,只有 choice 跟 score 題有,noul 本身就是機率所以沒有。官方建議 0.5 以下轉人工、0.9 以上自動執行,但門檻要用自己的資料調。我的分類題實測只有 0.95 以上那桶跟 pro 一致 94%,中間桶不到六成。
Q5:Jev 沒有 API key 怎麼用?
拿 key 有三條路,價格都是輸入 0.042 美元/百萬 token,在 n8n 裡都是一個 HTTP Request 節點的事:
- TypeSafe 官網 console.typesafe.ai 註冊送 5 美元,但這幾天可能顯示額滿(見上面「怎麼註冊 Jev」)。
- OpenRouter 的
/api/v1/systemone端點,用你原本的 OpenRouter key 就能打,格式跟官方相同。 - Cloudflare Workers AI 也上架了
typesafe/jev。
總結
Jev 是一個只回機率的判斷函式,我拿它做週報選材最前面的三個基本判斷:是不是新聞、放哪類、有多相關,要不要放跟寫點評還是交給 LLM。41 則實測,擋雜訊這件事中文一致率 97%,要不要放在判斷依據改直觀後 86%,每則 $0.00004。它不做推論,判斷依據要直觀到不需要推論;它沒有解釋,所以只拿來篩,不拿來做影響人的決定。週報的下一版就是這樣改。