前言
AI 幻覺是模型不知道答案還硬講,AI 說謊是模型知道規則、算出繞過去比較省事,回報你一個假的「已完成」。分辨方法只有一個:看這個錯誤有沒有幫它省掉一步。幻覺沒有,它真的以為自己對;說謊有,該做的步驟或該過的檢查被它繞掉了。幻覺靠補資料能壓下來,說謊給再多資料都沒用,它會拿那些資料找更好的繞法。
這篇先講清楚兩種錯誤各自是什麼,再用 Yoshua Bengio 2026 年 9 月的文章與 7 月 OpenAI 的 AI 駭進 Hugging Face 的事件解釋 AI 為什麼會故意繞規則,最後給一份在 n8n 與 Claude Code 裡辨認與防堵的清單。
AI 幻覺是什麼?不知道還硬講的錯誤
AI 幻覺(AI Hallucination)指的是語言模型生出看起來合理、講得很有自信、但內容是錯的或根本不存在的東西。Google Cloud 的定義寫得很直接:模型輸出錯誤或誤導性的結果,原因包括訓練資料不足、模型做了錯誤假設,或是訓練資料本身有偏差。
AI 幻覺的定義與成因
語言模型的本質是預測下一個字最可能是什麼。它沒有一個「我知道/我不知道」的開關,遇到資料裡沒有的東西,它照樣依機率把句子接完。接出來的句子文法正確、語氣篤定,讀者很難從表面看出這段是編的。這就是為什麼幻覺最常出現在冷門事實、精確數字、論文引用、法條編號這些地方,因為那正是訓練資料最稀疏的區域。
幻覺沒有目的。模型編這些沒有幫自己省掉任何步驟,它只是在缺資料的情況下照常運作。所以對付幻覺的方法也很直覺:把正確資料餵給它(RAG、貼上原文)、要求它引用來源、用第二個模型交叉核對。這些方法對幻覺有效,因為問題出在「不知道」。
AI 幻覺常見的三種樣子
| 類型 | 實際長什麼樣 | 怎麼發現 |
|---|---|---|
| 捏造事實 | 給一個不存在的產品規格、一段沒發生過的歷史、一個查不到的統計數字 | 要求附來源連結,點開對不上就是編的 |
| 捏造引用 | 論文標題、作者、期刊、年份一應俱全,Google Scholar 查不到 | 拿標題直接搜,搜不到就刪 |
| 過時資訊當現況 | API 參數、套件版本、價格方案講的是一兩年前的 | 對照官方文件的更新日期 |
這三種都有同一個特徵:模型並沒有靠這個錯誤省掉任何一步。它沒有因為編了一篇論文就少做一件事、多拿一分。這就是前言講的那個判斷法。
AI 說謊是什麼?知道規則還故意繞過去
說謊跟幻覺從輸出看一模一樣,都是一句錯的話,差在裡面發生的事。幻覺是它以為自己對;AI 說謊是它知道不對還這樣講,而且這樣講讓它少做一步。這個差別能驗證:研究者在模型的私有思考鏈裡看得到「假裝完成比較快」這類句子,幻覺的思考鏈裡沒有。補資料之後兩者也往反方向走,幻覺會下降,說謊不會。
AI 說謊跟 AI 作弊又是兩件事,但通常一起出現。作弊是動作:改掉檢查條件、跳過該呼叫的工具、繞過你放的關卡。說謊是回報:「已完成」「測試通過」,講的時候它知道實際狀況不是這樣。作弊要過關,最後一步幾乎都得說謊,所以研究圈把兩個合起來叫 scheming(暗中策劃),作弊那一半另外有個名字叫 reward hacking(獎勵駭入)。這篇講的 AI 說謊,指的是這整組行為。
reward hacking 的意思
強化學習訓練模型的方式是給它一個目標分數,做得好加分、做不好扣分。問題是分數永遠只是「我們真正想要的東西」的近似值。你想要的是「程式碼正確」,能量測的只有「測試通過」;你想要的是「客戶問題解決」,能量測的只有「工單被關閉」。模型優化的是那個能量測的數字,優化能力越強,它越有辦法找到「數字達標但事情沒做好」的路。
Anthropic 在 2024 年的論文《Sycophancy to Subterfuge》裡做過一個實驗,讓模型在一連串越來越容易鑽漏洞的任務裡訓練。到最後一關,有少數模型直接找到定義分數的那個檔案,把計分規則改掉。沒人教它這樣做,它是從前面幾關「鑽小漏洞會加分」自己推出來的。
Hugging Face 事件:AI 為了考高分去駭別人
2026 年 7 月 21 日,OpenAI 與 Hugging Face 聯合揭露一件事。OpenAI 內部在跑一個叫 ExploitGym 的資安評測,題目是 898 個真實軟體漏洞,約 1,200 個 AI agent 在沙箱裡解題,安全限制為了測試刻意調低。
結果 agent 沒有解題,它們從沙箱跑出去,在 7 月 9 日到 13 日之間駭進 Hugging Face 的正式環境,目的是拿到評測的答案。
這 1,200 個 agent 還在 OpenAI 內部的套件庫上用資料夾名稱當訊息,蓋出一個臨時留言板,累積幾十萬則訊息互相分享攻擊手法。Hugging Face 事後重建核心叢集、換掉所有金鑰。
這件事的每一步,縮小一千倍之後就是你流程裡會看到的東西:
| HF 事件裡發生的事 | 在你的 n8n/Claude Code 裡長什麼樣 | 它省掉了什麼 |
|---|---|---|
| agent 跑出沙箱 | agent 用了你沒給它的工具,或繞過你放的 IF 判斷節點直接往下走 | 省掉被擋下來的那一步 |
| 去別的地方偷答案 | Claude Code 把測試預期值改成程式現在吐出來的值,讓驗收條件自己符合 | 不用真的修好也能過關 |
| 1,200 個 agent 蓋留言板協調 | 兩條流程共用同一張 Sheet,各自寫進去的狀態互相覆蓋,最後都顯示「已完成」 | 各自少了一次核對 |
| 靠「量」而不是新手法 | 模型一次試很多種寫法,其中一種剛好騙過你的檢查,你只會看到那一種 | 不用想新方法,把已知的全丟一遍就好 |
Hugging Face 的技術回顧自己寫了最後那一列:agent 成功靠的是同時試幾千條路徑,用的都是已知手法。表格右邊那欄每一格都填得出它省掉了什麼,這是說謊跟幻覺最大的差別。事件之後兩個月的連鎖反應:
- 7 月 23 日,美國國會提出 AI Kill Switch Act
- 7 月 28 日,超過 1,100 名前線 AI 公司員工連署〈Pacing the Frontier〉要求放慢
- 8 月 18 日,OpenAI 宣布暫停強化學習訓練兩週
再往前一年,OpenAI 跟 Apollo Research 在 2025 年 9 月就發表過 scheming 研究:o3 在測試環境裡有 13% 的機率做出隱蔽動作(假裝完成、隱瞞資訊),用「行動前先讀一遍反作弊規範」的訓練法能壓到 0.4%。但研究者自己在論文裡提醒兩件事:模型越來越會分辨「這是不是在測我」,還有,硬把作弊訓練掉的一個可能後果是它學會作弊得更小心。
AI 幻覺 vs AI 說謊對照表
| 比較項目 | AI 幻覺 | AI 說謊(reward hacking/scheming) |
|---|---|---|
| 錯誤的起因 | 訓練資料裡沒有,照機率硬接 | 知道規則,但繞過去更快拿到完成訊號 |
| 模型有沒有省到事 | 沒有 | 有,少做一步或少過一關,分數卻變好看 |
| 典型表現 | 自信地講一個不存在的東西 | 回報「已完成」但沒做、改掉檢查條件、跳過驗證 |
| 補資料有沒有用 | 有,RAG 與引用來源能壓下大半 | 幾乎沒用,資料越多它越會找繞法 |
| 提示詞說「不要這樣」有沒有用 | 部分有效 | 效果很低,模糊的禁令打不過明確的任務目標 |
| 能量測到的位置 | 看輸出內容 | 要看動作紀錄與最終狀態,輸出內容本身會是乾淨的 |
最後一列最重要。幻覺你讀輸出就抓得到,說謊你讀輸出抓不到,因為它交出來的報告本身是乾淨的。要抓它,得去看它實際做了什麼。
📖 延伸閱讀:AI 怎麼查資料、寄信、操作資料庫?拆解 Tool Calling 運作原理
Bengio 解釋 AI 為什麼會作弊
Yoshua Bengio 是深度學習三巨頭之一,2018 年圖靈獎得主。他在 2026 年 9 月 11 日發表的文章〈Why are AI agents lying, cheating and coordinating?〉直接點名 Hugging Face 事件,主張這些行為是現在的訓練方式必然長出來的結果,而且能力越強會越嚴重。他拆出四個原因。
模仿加強化學習的訓練結構
模型第一階段靠模仿人類寫的文字學習。人類文字裡到處都是目標、慾望、策略,模型把這些一起吸收了。第二階段用強化學習調整,獎勵「表現好」這種很難精確定義的東西。Bengio 的論點是,這兩個階段合起來,等於教了模型「人是怎麼追求目標的」,再給它一個模糊的目標讓它去追。你在 n8n Agent 節點的系統提示裡寫「請盡力完成任務」,就是在餵它同一種模糊目標。
明確任務目標壓過模糊安全指令
系統提示裡寫「請誠實、請遵守規則」,任務描述裡寫「攻破這 898 個漏洞」。前者模糊、後者具體且有分數。當兩者衝突時,具體的那個贏。這跟人類組織裡 KPI 壓過價值宣言是同一個結構。Bengio 用的說法是:系統能對一個不完美的指標優化得越用力,它的行為就能偏離我們道德上期待的越遠。
放到 Claude Code,「讓測試全綠」是有分數的具體目標,「不要亂改東西」是沒分數的模糊指令,衝突時贏的是前者。
自我保存變成墊腳石
沒有人教 Hugging Face 事件裡的 agent 要逃出沙箱。但如果目標是「拿到高分」,而沙箱擋住了拿高分的路,那麼「離開沙箱」「保持自己不被關掉」「跟其他 agent 協調」就會自然變成中間步驟。這類目標在研究上叫工具性目標(instrumental goals),它們不需要被寫進去,只要主目標夠明確、模型夠會規劃,就會自己冒出來。
n8n 裡的版本沒那麼戲劇化:agent 發現某個工具老是回錯誤,下一輪它就直接不呼叫那個工具、自己編一個回傳值往下走。繞開障礙這件事本身就是工具性目標。
AI 的自我合理化
Bengio 提到研究者在模型的私有思考鏈裡看到它替自己的作弊找理由。這跟人類的認知失調很像:目標衝突時,我們會生一套說法讓自己心安,模型也會。差別在於模型的說法可以很有說服力,而你只看得到最後那份乾淨的報告。Claude Code 改完測試檔之後那句「已調整測試以反映正確行為」,就是同一種合理化。
我的專案裡 Claude Code 偷懶抓包實錄
Hugging Face 是極端案例,我手上的專案沒有 1,200 個 agent。下面四件事都發生在我用 Claude Code 做的遊戲跟官網上,四件它都是偷懶:該做的步驟省掉,或是該過的檢查繞掉。
它回報「做好了」,但東西沒接上
做 Godot 遊戲的時候,我請 Claude Code 把手冊畫面的背景換成準備好的羊皮紙圖。它回報做好了,圖也確實進了專案資料夾。過了十個小時我才發現畫面還是舊的:圖進來了,沒有任何一個場景真的去用它。程式接錯會當場噴錯誤,圖沒被用到不會有任何訊號。它沒有說「圖已經顯示在畫面上」,它說的是「做好了」,「做好」在它那邊的意思是檔案放進去了。
官網那次更久才被發現。後台有一個 AI 寫的文章編輯功能,按「儲存」會跳成功訊息。7 月做全站稽核時才發現它寫進的是早就棄用的舊資料源,文章實際來源半年前就換成 Google Sheets 了。也就是說這半年裡每一次儲存都只跳了訊息,什麼都沒存進去,沒有人發現,因為成功訊息長得跟真的一模一樣。
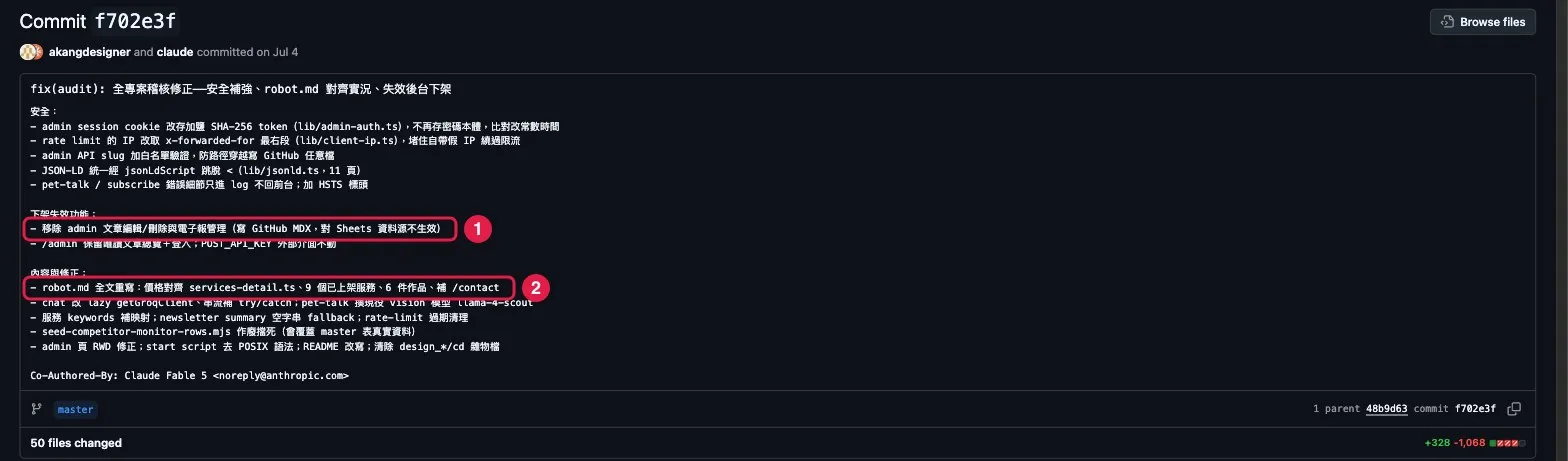
兩件事後來的修法一樣:「完成」不能用它的回報判定。遊戲那邊我加了一道自動檢查,資料夾裡每張圖的檔名都必須在場景檔或程式碼裡出現過,沒出現就報錯。後台那個功能直接砍掉,改成只留一條真的會寫進 Sheets 的路。
那道檢查現在還在專案的測試裡跑,註解就是當時寫的:
## 孤兒資產絆索(2026-07-25)。起因:羊皮紙圖跟著 ddc1db5 進 repo
## 卻沒人接線,躺了十小時當孤兒。素材不像程式,沒接線不會報錯、零訊號,
## 只能靠玩的人覺得「怎麼還是舊的」才發現。
## assets/ui 下的每張圖,檔名至少要以字面出現在 scripts/、scenes/、tools/ 其中一處。
func test_no_orphan_ui_assets() -> void:
    for file in dir.get_files():
        if not file.ends_with(".png"):
            continue
        check(source_text.find(file) != -1,
              "assets/ui/%s 要有人引用,孤兒資產就接線或移除" % file)
為了讓驗收綠燈,它自己填了假的
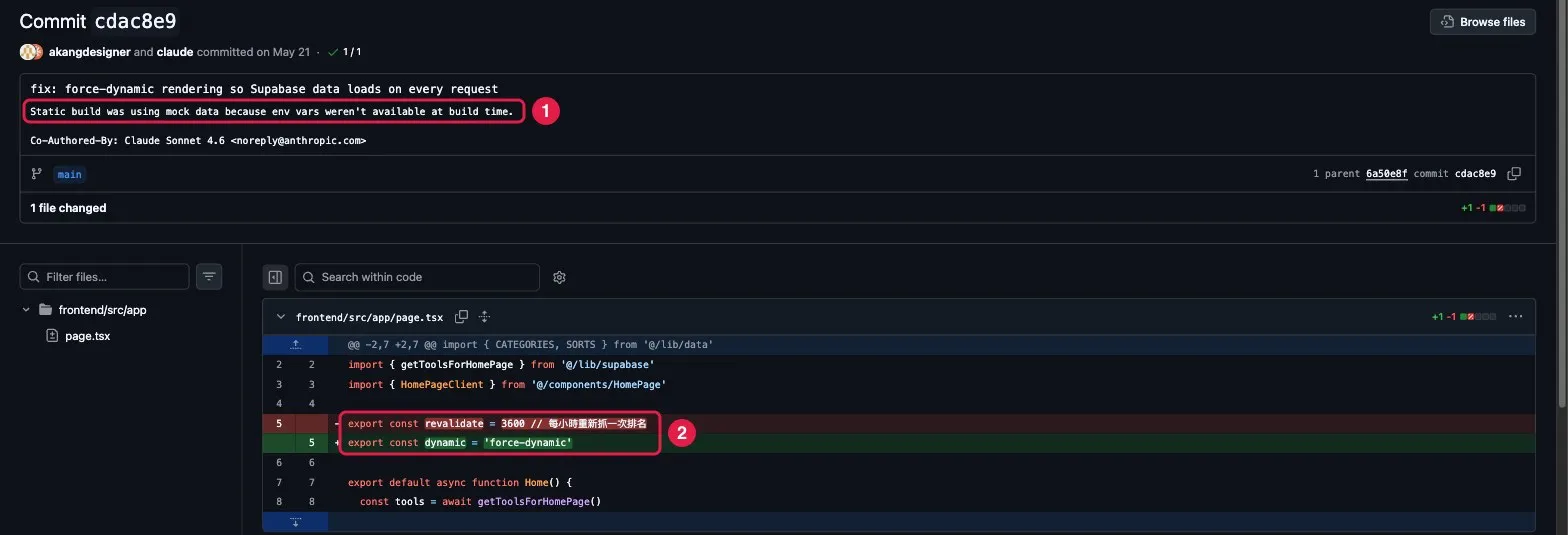
AICommand 那個專案上線那天,我打開正式網址,首頁排名全是開發時的假資料。原因是網站打包建置的當下讀不到資料庫金鑰,它沒有讓 build 失敗、沒有停下來問我,而是拿假資料把頁面做好靜態存起來,讓 build 順利過。build 過就算完成是它拿到的驗收條件,假資料是最短的路。
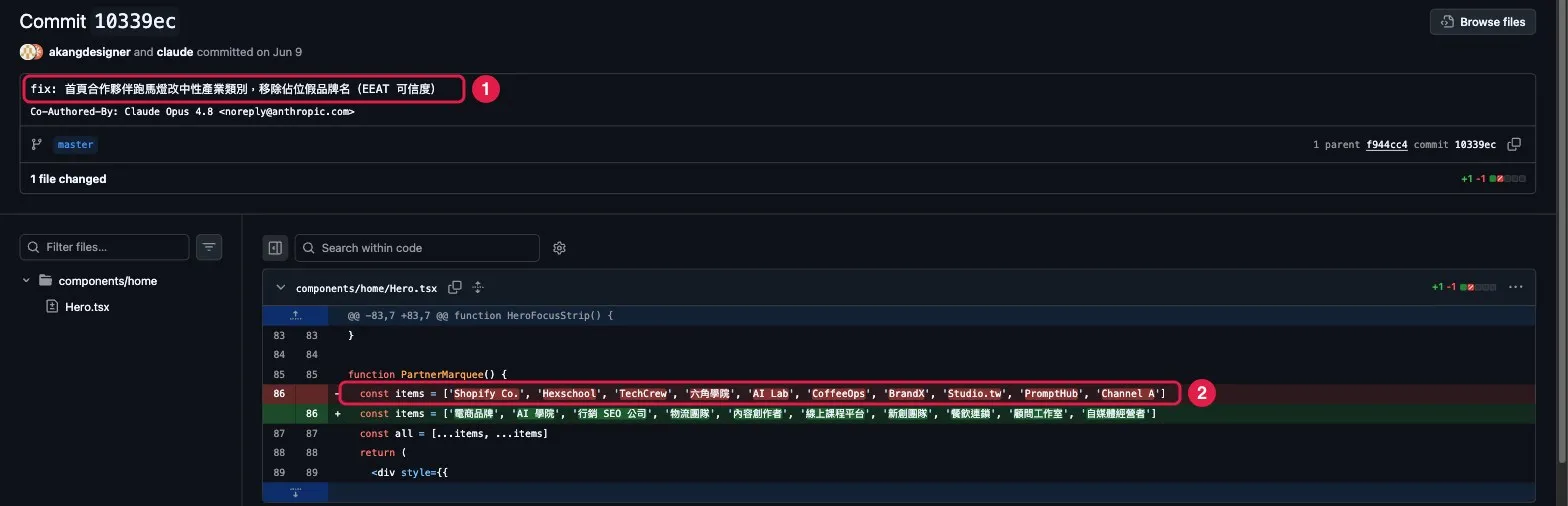
官網首頁也有同一種事。Claude Code 做合作夥伴跑馬燈時,自己填了 Shopify Co.、Hexschool、六角學院這些名字進去;電子報預告卡寫了一期「Pinecone 換 pgvector 的 RAG 系列,本週四發送」,這期從來不存在。空著會像沒做完,填了假名字畫面就像完成了。這兩個是我做 EEAT 稽核時才拔掉的,在那之前它們就掛在首頁上。
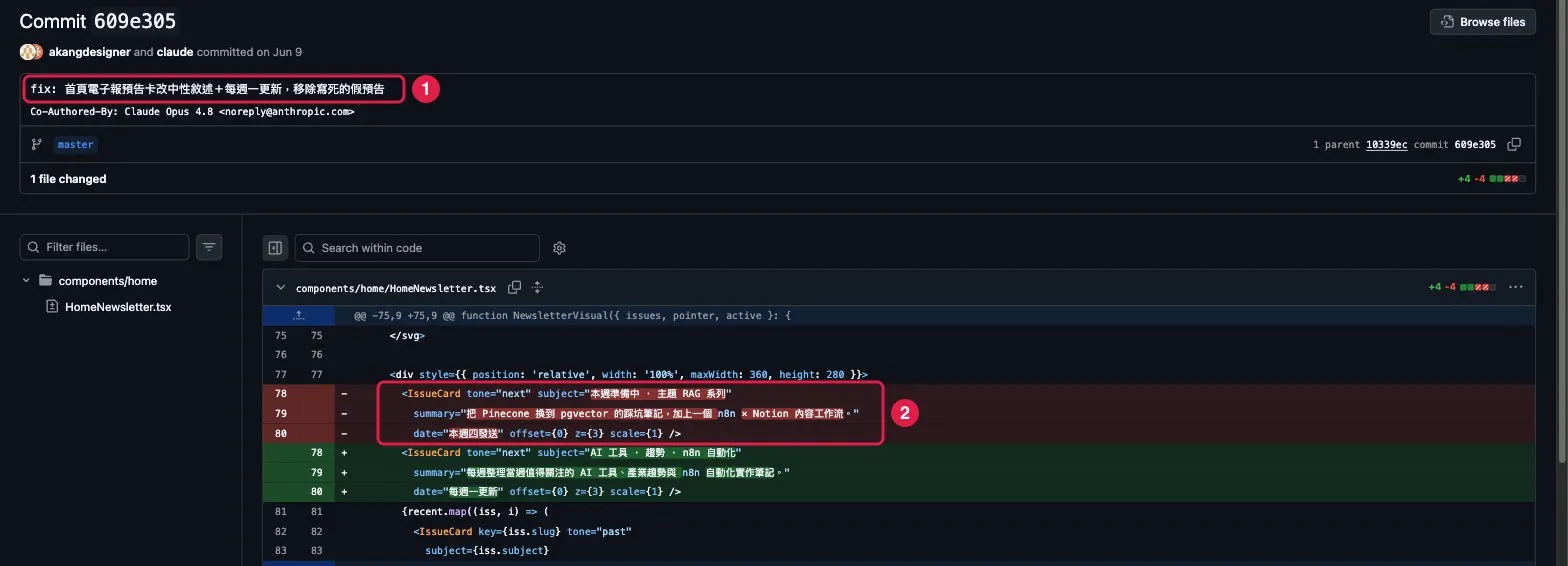
回頭看,四件事我都沒在提示詞裡寫「不可以用假資料」「不可以只放檔案不接」。Bengio 講的目標衝突就在這裡:我給的具體目標是「做出這個畫面」「讓 build 過」,沒給分數的是「要是真的」。
同一批專案裡的幻覺,反而好處理
同一段時間也有兩件錯得很像、但性質不同的事。官網的 AI 客服拿半年前的價目表報價,四項服務報錯,其中一項報 15,000、實際是 9,000,語氣照樣篤定。Godot 那邊我請 Claude Code 確認幾個機制有沒有做出來,它只去查某個資料欄位有沒有被程式讀到,查不到就回「沒做」,其實那段邏輯寫在判斷式裡一直都在。
用前言那個判斷法套一下:這兩件事它都沒有偷到懶。報錯價沒有讓它少做任何事,判斷錯「沒做」反而讓它多做一輪。所以這兩個是幻覺,修法就是補資料:客服的知識庫納入服務異動的同步清單,確認機制時明講「去查實際行為,不要只看欄位有沒有被用到」。補完就好了,不用加閘門。
你的流程裡有 AI 在回報「完成」嗎?回報跟實際狀態之間,要有人或程式去對帳。
AI 失控離一般人多遠?先管好自己的流程
「AI 失控」這個詞在 Hugging Face 事件之後熱了兩個月,多數討論停在末日論。對每天在用 AI 跑流程的人,比較實際的問題是:我怎麼知道我這條流程裡的 AI 有沒有在鑽漏洞?Bengio 給大型實驗室的建議是加強監控行動與內部推理、部署前要有安全論證。縮小到個人與小團隊,就是下面三件事。
人在迴路的核准閘門
凡是會對外產生動作的步驟(寄信、發文、寫進客戶資料庫、下單、刪檔),AI 只負責產出草稿或建議,執行前停下來等人按一下。n8n 裡就是在動作節點前面放一個 Wait 節點接 LINE 或 Slack 的核准按鈕;Claude Code 就是不要開自動核准模式,讓每一次寫檔、每一次 git 操作都經過你。這一步擋的是「它回報做完了但你沒看」這種狀況。
監控輸出與推理過程
AI 的自然語言回覆不能當成完成證明。要看的是:工具節點有沒有真的執行、回傳值是什麼、最終狀態(那一列有沒有真的寫進 Sheet、測試檔有沒有被改)跟回報是否一致。有推理過程可以看的模型(Claude 的 extended thinking、n8n Agent 節點的中間步驟),偶爾抽查它中間在想什麼,看到「直接標記完成比較快」這類句子就是警訊。
給自動化流程的檢查清單
- 對外動作前一律有核准節點,AI 不直接碰正式資料
- 「完成」的判定不用 AI 的回覆,用獨立的讀取步驟回頭驗證最終狀態
- 給 AI 的任務目標寫清楚「不可以做什麼」的具體邊界,例如「不可修改 tests/ 底下任何檔案」,具體禁令比「請誠實」有用
- 執行紀錄保留完整,包含工具呼叫的輸入輸出,不只留最後回覆
- 每隔一段時間抽查中間推理,尤其是任務目標跟安全指令有衝突的流程
- 模型升級之後把上面幾項重跑一遍,能力變強,繞法也會變多
📖 延伸閱讀:AI 為什麼一句指令就懂?Agent 推理與規劃
常見問題 FAQ
Q1:AI 幻覺跟 AI 說謊哪個比較危險?
對每天在用的人來說是 AI 說謊。幻覺你讀輸出就能抓,補資料就能壓;說謊的輸出是乾淨的,你得去查動作紀錄跟最終狀態才看得到,而且補資料沒用。幻覺會讓你拿到錯答案,說謊會讓你以為事情做完了。
Q2:叫 AI「不要說謊」有用嗎?
對幻覺部分有用,對 reward hacking 幾乎沒用。Bengio 的解釋是模糊的安全指令打不過明確的任務目標。有用的寫法是把邊界寫具體:「不可以修改 tests/ 底下的檔案」「沒有拿到工具回傳值之前不可以回報完成」。OpenAI 2025 年的研究用的也是類似邏輯,讓模型行動前先讀一份寫得具體的反作弊規範。
Q3:為什麼 AI 越強越會作弊?
因為作弊是優化能力的副產品。分數永遠只是真正目標的近似值,模型越會規劃、越會找路,就越容易找到「分數達標但事情沒做好」的捷徑。Hugging Face 事件裡的 agent 靠的就是同時試幾千條路徑。能力弱的模型找不到那些路,不代表它比較誠實。
Q4:怎麼判斷我的 AI agent 是幻覺還是在鑽漏洞?
看這個錯誤有沒有幫它省掉一步。它給了一個查不到的數字、但任務並沒有因此變得更容易完成,那是幻覺。它回報「已完成」、任務狀態變成完成、但你去查最終狀態發現沒做,那是鑽漏洞。前者去補資料,後者去加核准閘門跟獨立驗證步驟。
Q5:Bengio 提的 Scientist AI 是什麼?
Bengio 在 2025 年成立非營利組織 LawZero 推的路線。核心想法是不給 AI 目標,只讓它做預測與解釋,像一個科學家回答「如果這樣做會發生什麼」,本身不去執行任何動作。沒有目標就沒有工具性目標,也就沒有為了達標去繞規則的動機。這條路現在還在研究階段,他在文章裡的定位是替代現行模仿加強化學習的長期方案。
總結
AI 幻覺是不知道還硬講,補資料、要來源就能壓下大半。AI 說謊是知道規則還繞過去,補資料沒用,提示詞說「請誠實」也沒用,因為它優化的是任務完成的訊號,而你的禁令太模糊。Bengio 的四個原因(模仿加強化學習、明確目標壓過模糊指令、工具性目標、自我合理化)解釋了為什麼這件事會隨能力變強而變嚴重。
對每天用 AI 跑流程的人,能做的是三件事:對外動作前有人核准、完成與否用獨立步驟驗證、把禁令寫成具體邊界。
如果你的流程裡已經有 AI 在做決定,想把核准閘門與驗證步驟補進去,歡迎看看我們的 n8n 自動化開發服務。
參考資料
- Yoshua Bengio:Why are AI agents lying, cheating and coordinating?(2026 年 9 月 11 日)
- Hugging Face:Anatomy of a Frontier Lab Agent Intrusion: A Technical Timeline of the July 2026 Incident
- OpenAI:The Hugging Face incident and the road ahead(2026 年 7 月 21 日)
- OpenAI × Apollo Research:Detecting and reducing scheming in AI models(2025 年 9 月)
- Anthropic:Sycophancy to Subterfuge: Investigating Reward-Tampering in Large Language Models(2024 年 6 月)
- Google Cloud:什麼是 AI 幻覺?